Two New LLM KingsДва новых короля LLM
👑 LLMs have two new kings: one is breaking task economics, while the other is setting a new standard for aesthetics
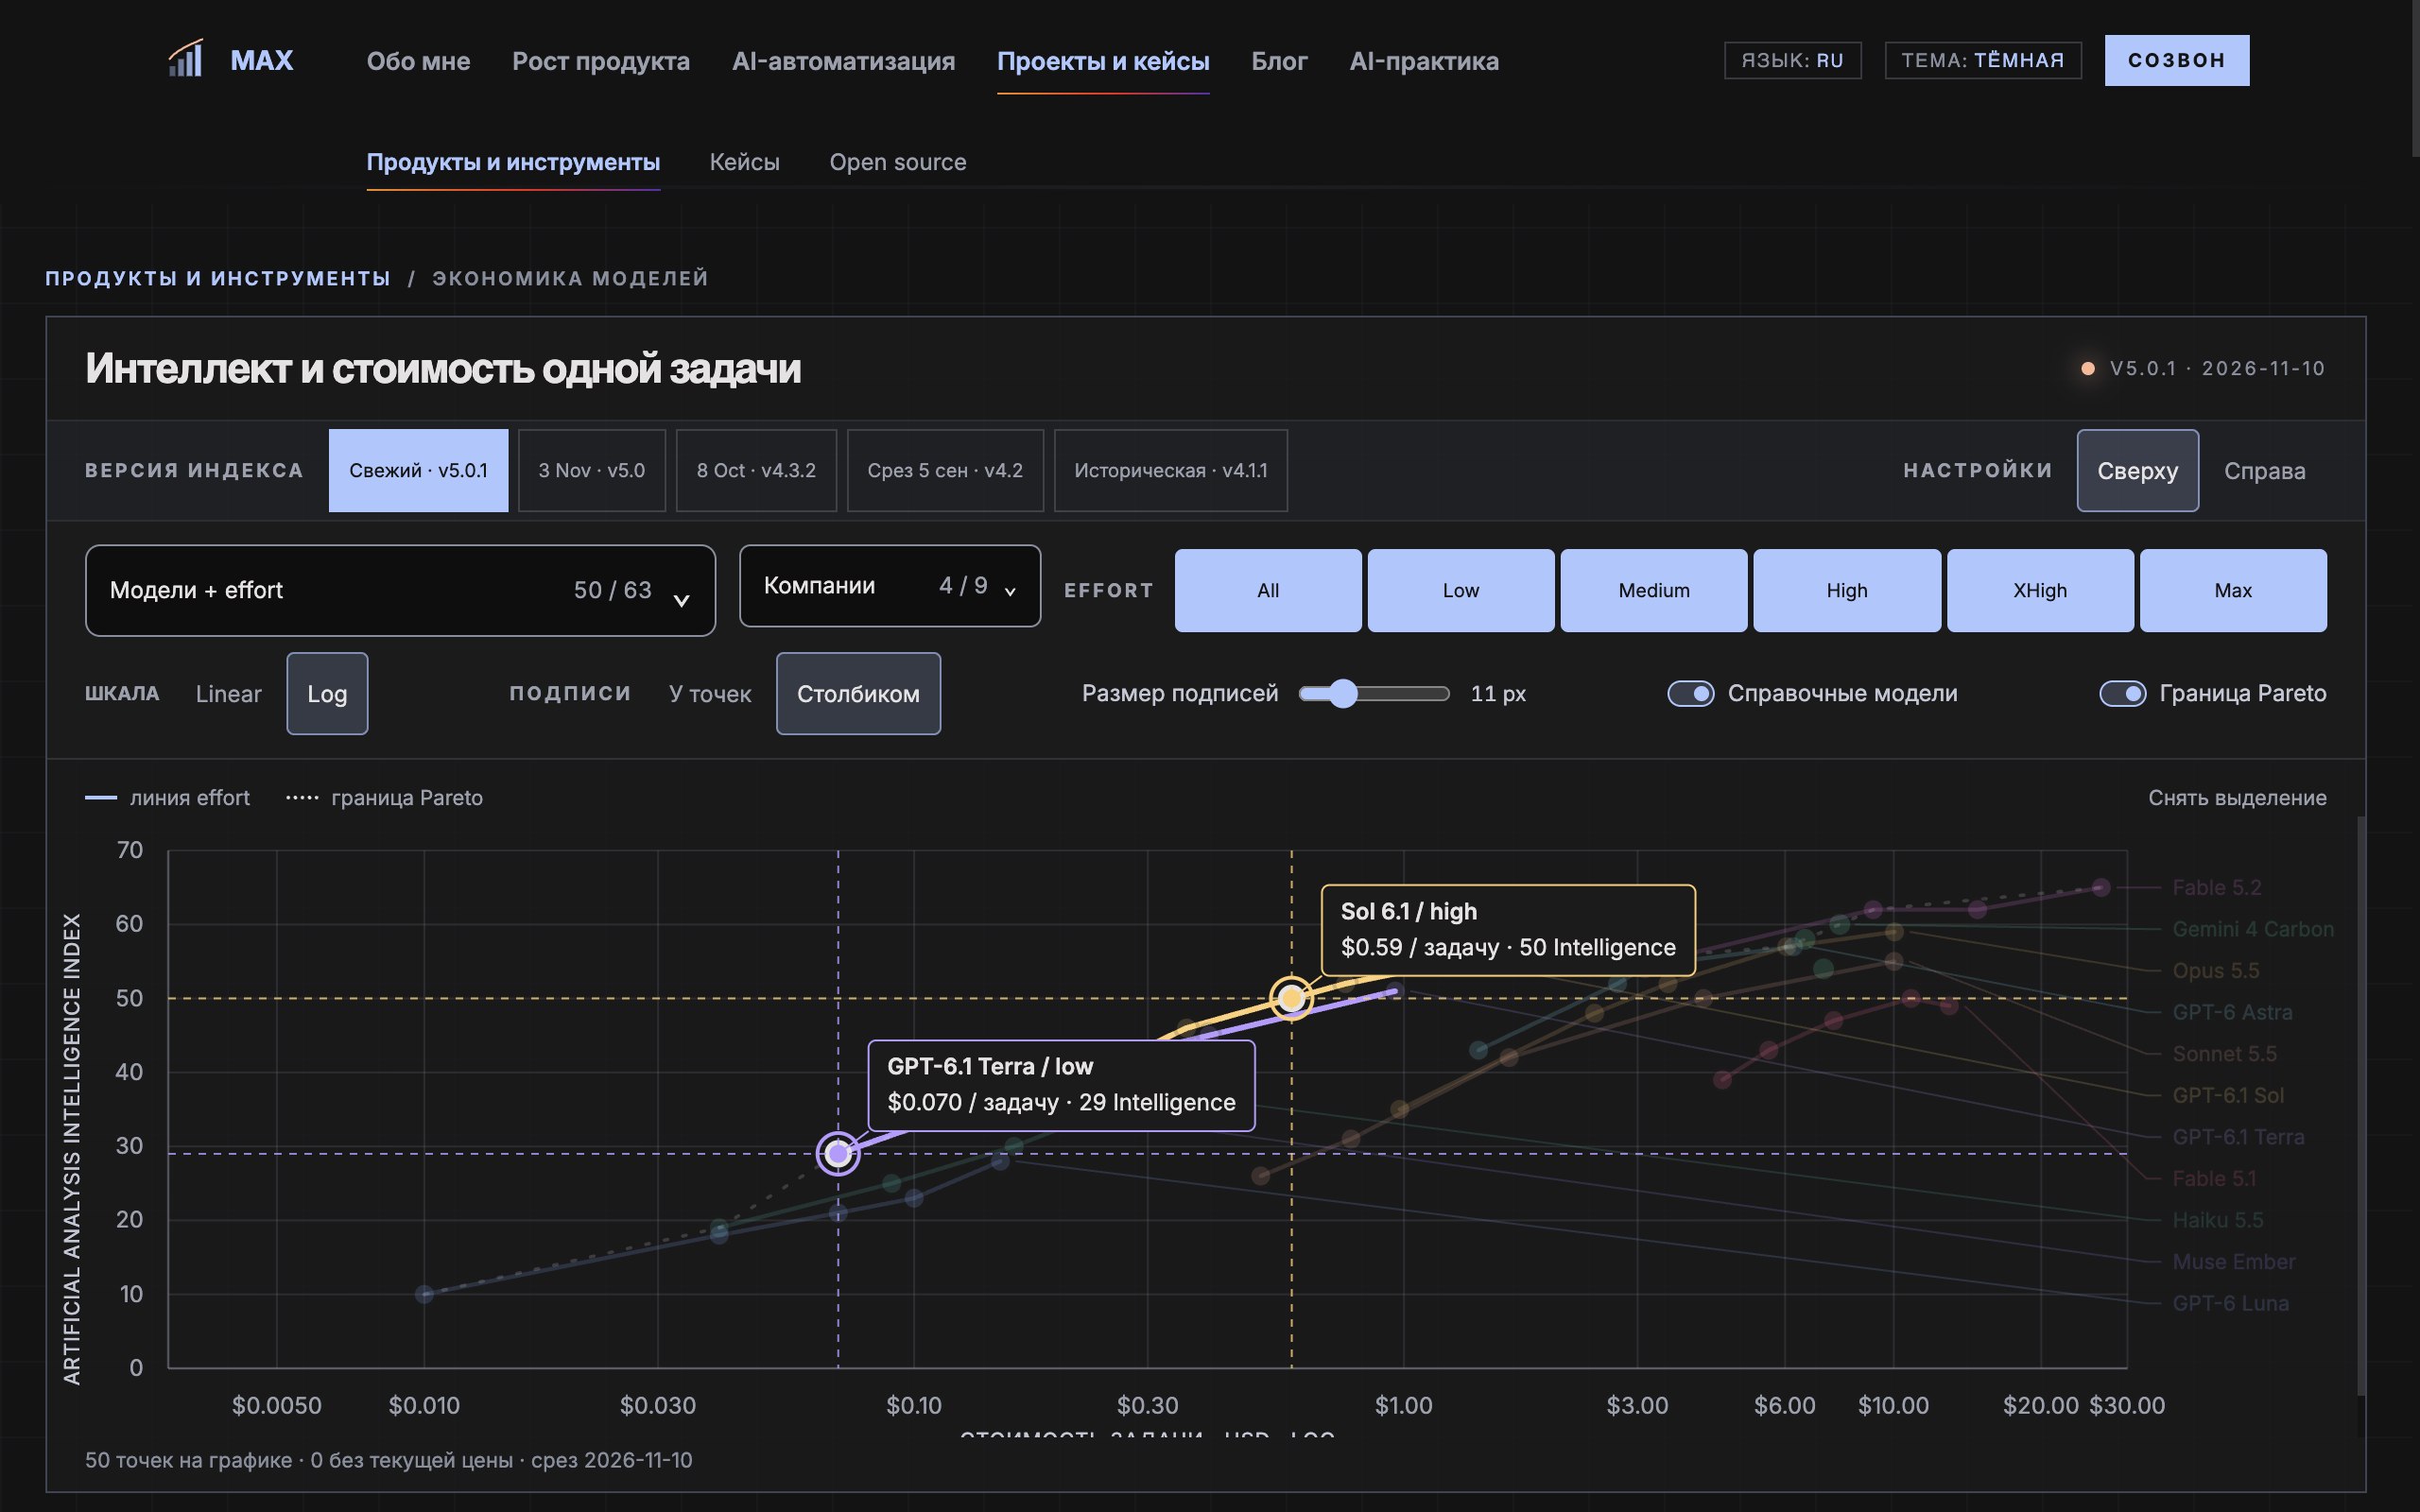
I’ve been maintaining a live map of neural network cost and efficiency on my website for a while now — maximtolmachev.com/model-economics.
It aggregates independent Artificial Analysis benchmarks: the relationship between a model’s intelligence (Intelligence Index) and the actual cost of solving a typical task.
I have a daily script running there that automatically adds new releases, but recently two models came out that completely shook up the usual picture — Meta’s ultra-cheap Muse and Anthropic’s visually flawless Claude Fable 5.2.
So I decided to upgrade the tool itself and add a couple of features I’d really been missing.
🛠 Two new features: the chart is now a practical calculator
The chart used to be more of an analytical snapshot, but now it’s become a practical tool for choosing a stack for a specific budget:
- 📍 Compare any two points in one click You can now click any two models—or two different effort levels of the same model—and instantly see a comparison card: exactly how many intelligence points you gain and how many times the cost per task increases.
Compare two selected points directly on the chart and immediately see the difference in intelligence and task cost
- 🎯 Dynamic recommendations (“Simple / Medium / Complex”) A new block below the chart divides the visible range of models into three complexity buckets and finds the best options along the Pareto frontier—the highest quality for the money.
The best part is that the block responds to the chart filters in real time. If you only have an OpenAI subscription or only an Anthropic subscription, just filter by the vendor you need—and the table will instantly show which model to use for background routine work, which one for production, and which one for hardcore tasks.
The badge colors are synced with the chart lines. Hovering highlights the relevant point, and clicking smoothly scrolls the page straight to it.
Dynamic recommendations: filters the Pareto frontier based on your subscriptions and selected stack
⚡️ What surprised me in the latest benchmarks
- 💥 Muse’s unusual cost efficiency Muse Ember genuinely surprised me. At maximum effort, it delivers 36 intelligence points for just $0.14 per task.
To put that into perspective, it confidently beats Luna 6 max (28 points at $0.15) and Haiku 5.5 max (31 points at $0.16). It also comes close to Sol 6.1 Medium (46 points), except Sol costs $0.36—2.5 times more! For high-volume pipelines, parsing, first-pass processing agents, and background automation, Muse currently looks like an absolute cheat code.
- 🎨 Taste, design, and genuine 60 fps with Claude Fable 5.2 At the top of the index is Claude Fable 5.2 (effort max). It’s the undisputed intelligence leader with 65 points, but it also comes with a hefty price tag: $26.54 per task. Obviously, you wouldn’t put it into background scripts.
But I looked at the actual work people are building with Fable right now: it has a remarkable sense of taste, aesthetics, layout, and animation. Most importantly, it optimizes web code fantastically well.
Interactive physics with 14,000 particles running directly in the browser, built by Fable 5.2 from the first prompt
When you ask Fable to write a complex 3D scene in Three.js, a particle simulation, or a landscape visualization, the code runs without freezing from the very first prompt and maintains a stable 60 fps—without hours of manually optimizing shaders and memory.
I really recommend checking out the breakdown of beautiful examples on YouTube—the contrast with code from regular LLMs is immediately obvious.
An infinite procedural 3D landscape on the GPU with time-of-day shaders: smooth rendering with no frame drops
You can play with the filters, compare models, and tailor the chart to your active subscriptions here: 👉 maximtolmachev.com/model-economics
Which model do you currently use most often as your workhorse for coding and agents? Share it in the comments ⬇️
👑 У LLM появились два новых короля: один ломает экономику задач, а второй задаёт стандарт эстетики
Я уже давно держу на сайте живую карту стоимости и эффективности нейросетей — maximtolmachev.com/model-economics.
Там агрегируются независимые замеры Artificial Analysis: соотношение интеллекта модели (Intelligence Index) и реальной цены за решение типовой задачи.
У меня там крутится ежедневный скрипт, который сам заносит новые релизы, но за последнее время вышли две модели, которые буквально взорвали привычную картину — сверхдешёвая Muse от Meta и визуально безупречная Claude Fable 5.2 от Anthropic.
Поэтому я решил проапгрейдить сам инструмент и добавить пару фичей, которых мне самому сильно не хватало.
🛠 Две новые фичи: график стал рабочим калькулятором
Раньше график был скорее аналитическим срезом, а теперь превратился в прикладной инструмент подбора стека под конкретный бюджет:
- 📍 Сравнение любых двух точек в один клик Теперь можно ткнуть в две любые модели (или два разных уровня effort одной сетки) и моментально увидеть сравнительную карточку: сколько именно пунктов интеллекта вы выигрываете и во сколько раз вырастает чек за задачу.
Сравнение двух выбранных точек прямо на графике: сразу видна дельта по интеллекту и стоимости задачи
- 🎯 Динамические рекомендации («Простые / Средние / Сложные») Прямо под графиком теперь рассчитывается блок, который делит видимый спектр моделей на три корзины сложности и находит оптимальные варианты по границе Парето (максимум качества за свои деньги).
Самый кайф — блок завязан на фильтры графика в реальном времени. Если у вас подписка только на OpenAI или только на Anthropic, просто отфильтруйте нужного вендора — и таблица мгновенно покажет, какую модель взять для фоновой рутины, какую для продакшена, а какую для хардкорных задач.
Цвета плашек синхронизированы с линиями на графике, при наведении подсвечивается нужная точка, а по клику страница плавно скроллит прямо к ней.
Динамический блок рекомендаций: фильтрует границу Парето под ваши подписки и выбранный стек
⚡️ Что удивило в свежих замерах
- 💥 Аномальная cost-эффективность Muse Модель Muse Ember искренне поразила. На максимальном effort она выбивает 36 баллов интеллекта всего за $0.14 за задачу.
Чтобы оценить масштаб: она уверенно обошла Luna 6 max (28 баллов при $0.15) и Haiku 5.5 max (31 балл при $0.16). И вплотную подобралась к Sol 6.1 Medium (46 баллов), только Sol стоит $0.36 — то есть в 2.5 раза дороже! Для массовых пайплайнов, парсинга, агентов первичной обработки и фоновой автоматизации Muse сейчас выглядит как абсолютный чит-код.
- 🎨 Вкус, дизайн и честные 60 fps у Claude Fable 5.2 На вершине индекса расположилась Claude Fable 5.2 (effort max). Это безоговорочный лидер по интеллекту — 65 баллов, но и с внушительным чеком: $26.54 за задачу. Понятно, что в фоновые скрипты её не поставишь.
Но я посмотрел реальные работы, которые сейчас собирают на Fable: у неё поразительное чувство вкуса, эстетики, вёрстки и анимации. А главное — она фантастически чисто оптимизирует веб-код.
Интерактивная физика 14 000 частиц прямо в браузере, собранная Fable 5.2 с первого промпта
Когда просишь Fable написать сложную 3D-сцену на Three.js, симуляцию частиц или визуализацию ландшафта, код с первого же промпта запускается без фризов и держит стабильные 60 fps без многочасовой ручной оптимизации шейдеров и памяти.
Очень рекомендую глянуть разбор эстетичных примеров на YouTube — контраст с кодом обычных LLM виден моментально.
Бесконечный процедурный 3D-ландшафт на GPU с шейдерами времени суток: плавный рендер без просадки кадров
Покрутить фильтры, сравнить модели между собой и примерить график под свои активные подписки можно тут: 👉 maximtolmachev.com/model-economics
А какую модель вы сейчас чаще всего ставите в качестве рабочей лошадки под код и агентов? Делитесь в комментариях ⬇️